
بگذارید با یک اعتراف شروع کنم: به نظر من SSIS و SQL Server اصلاً ابزارهای بدی نیستند. سالهاست دیدهام که کسبوکارهای جدی و بزرگی روی آنها میچرخند و آدمهای باهوش زیادی چیزهای فوقالعادهای با آنها ساختهاند. پس این نوشته قرار نیست نسخهی «بیایید همهچیز را بکوبیم و از نو بسازیم» باشد.
چیزی که میخواهم دربارهاش حرف بزنم کمی آرامتر و نامحسوستر است. یک لحظهای میرسد که یک پلتفرم داده، دیگر صرفاً مجموعهای از چند Job نیست و تبدیل به یک سیستم واقعی میشود. ابزارهایی که شما را تا این نقطه آوردهاند، معمولاً همان ابزارهایی نیستند که میتوانند جلوتر ببرندتان. اگر دادههایتان مدام در حال رشد است، بد نیست قبل از اینکه به این نقطه برسید، بدانید اصلاً چه شکلی است.
مشکلِ همهچیز در یک جعبه (One-Big-Box)
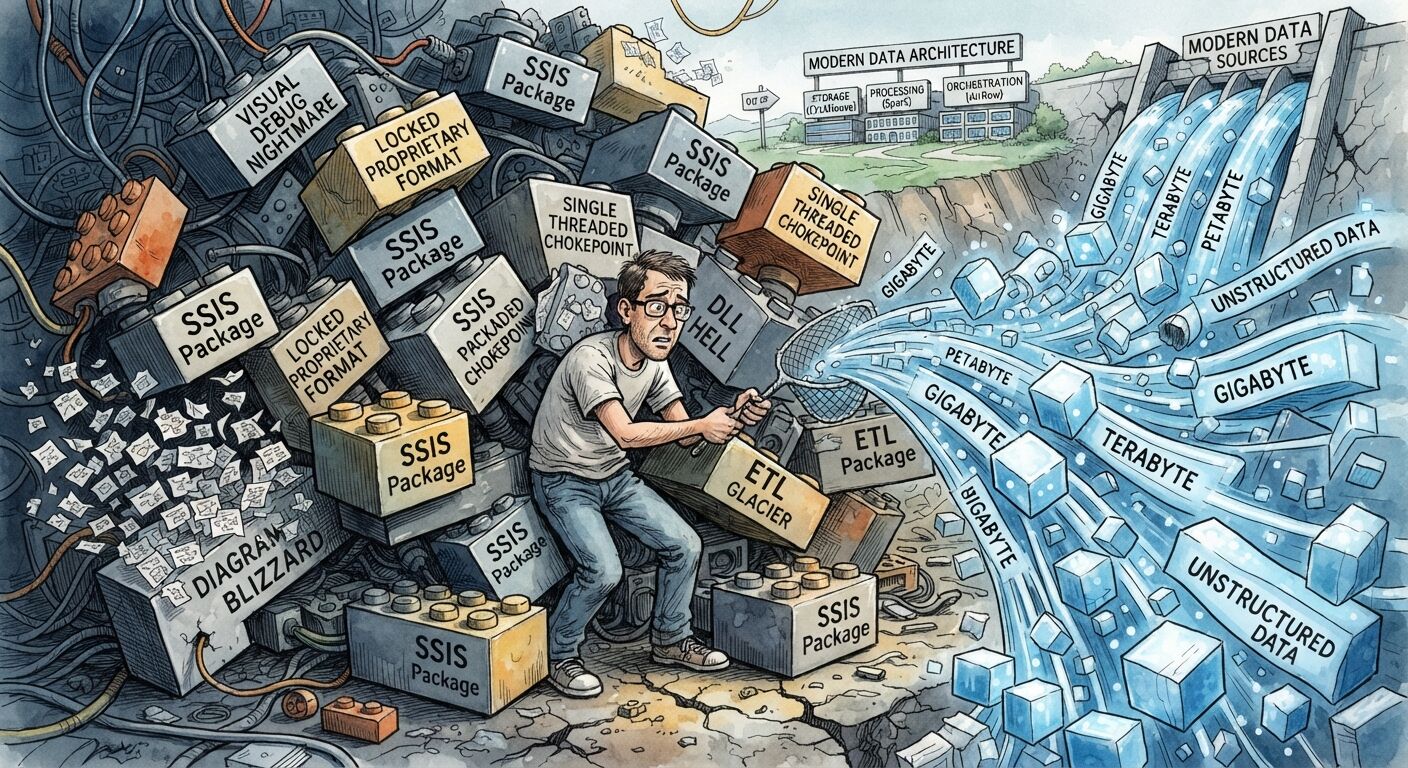
استک کلاسیک مایکروسافت شکل خیلی جمعوجور و راحتی دارد. یک سرور بزرگ. SQL Server دادهها را نگه میدارد، SSIS آنها را جابهجا میکند و شکل میدهد، و یک Scheduler هم همهچیز را شبها اجرا میکند. یک ماشین، یک تیم، و یک جا برای سر زدن وقتی مشکلی پیش میآید. برای مدت طولانی، این یک مزیت است، نه یک باگ.
دردسر از جایی شروع میشود که دادهها بزرگ میشوند. این معماری عملاً فقط یک جهت را بلد است: قورت دادن منابع (Scale Up). یک سرور بزرگتر، رم بیشتر، دیسکهای سریعتر، لایسنسهای بیشتر. بزرگ کردن سرور تا یک جایی جواب میدهد، اما خیلی قبلتر از اینکه از کار بیفتد، هزینههایش به طرز دردناکی سر به فلک میکشد.
و از آنجا که همهچیز روی یک سرور مشترک است، همهچیز هم سر منابع با هم میجنگند. یک بارِ سنگین روی سیستم، گزارشها را کند میکند. یک گزارش سنگین، بارگذاری دادهها را کُند میکند. کمکم کارتان به جایی میرسد که برنامهریزی کسبوکار را بر اساس حالوهوای یک ماشین تنظیم میکنید.
پایپلاینهای ناخوانا
ابزارهای گرافیکی در روز اول فوقالعادهاند. هر کسی میتواند یک دیاگرام را باز کند و تا حدی سر در بیاورد که چه خبر است. اما در مقیاس بزرگ، این ماجرا کاملاً برعکس میشود.
یک پایپلاین که در محیط طراحی کشیده شده، سخت Review میشود، سخت تست میشود، سخت میتوان روی آن Version Control داشت و تغییر دادنش بدون ریسک تقریباً غیرممکن است. هیچکس نمیتواند Pull Request یک دیاگرام را بخواند. وقتی چند نفر همزمان روی یک پایپلاین کار میکنند، هیچکس دقیقاً مطمئن نیست چه چیزی تغییر کرده. در نتیجه، تغییرات ترسناک میشوند و تغییرات ترسناک را هم آدمها آرام، با احتیاط زیاد و معمولاً نیمهشب انجام میدهند.
مهندسان نرمافزار خیلی وقت پیش این درس را یاد گرفتند: هر چیز مهمی باید کد باشد، در یک Repository زندگی کند، Review شود و تست داشته باشد. پایپلاینهای داده هم دقیقاً شایستهی همین احترام هستند. آنها پروژههای جانبی نیستند؛ محصولاتی هستند که بقیه به آنها وابستهاند.
سه کار، سه تکه
تغییر نگرشی که برای من از همهچیز مهمتر است همین است. یک پلتفرم داده سه کار کاملاً متفاوت انجام میدهد:
- ذخیرهی دادهها و پاسخ به پرسشها دربارهی آنها. این کارِ Database است.
- جابهجایی و تغییر شکل دادهها. این کارِ پردازش (Processing) است.
- تصمیمگیری دربارهی اینکه چه چیزی چه زمانی اجرا شود، و اگر چیزی شکست خورد چه اتفاقی بیفتد. این کارِ Orchestration است.
در معماری قدیمی، این سه کار در یک جعبه و یک خانوادهی ابزاری با هم ترکیب میشوند. اما در یک طراحی مدرن، شما آگاهانه اینها را از هم جدا میکنید. هر بخش فقط یک کار انجام میدهد، بهتنهایی مقیاسپذیر میشود (Scale میشود) و میتوان بدون دست زدن به دو بخش دیگر، آن را جایگزین کرد.
این یک ایدهی مُد روز نیست؛ صرفاً معماری خوب است. معیار محبوب من برای سنجش هر طراحی خیلی ساده است: «بعداً چقدر راحت میتوانم نظرم را عوض کنم؟» سیستمی که از تکههای جداگانه ساخته شده، اجازه میدهد هر بار فقط یک تکه را تغییر دهید. اما سیستمی که در یک جعبهی بزرگ حبس شده، فقط بهصورت یکجا قابل تغییر است؛ و دقیقاً همین سیستم است که هیچوقت تغییر نمیکند.
چرا ClickHouse انگار برای بیگ دیتا ساخته شده؟
SQL Server یک دیتابیس تراکنشی (Transactional) است. برای تعداد زیادی خواندن و نوشتنِ کوچک توسط کاربران متعدد ساخته شده؛ جایی که رکوردها مدام تغییر میکنند: سفارشها، مشتریان، پرداختها. در این کار واقعاً بینظیر است.
اما بیگ دیتا (Big Data) معمولاً شکل کاملاً متفاوتی دارد. دادهها اکثراً از راه میرسند و دیگر هیچوقت تغییر نمیکنند. پرسشها حجم عظیمی از داده را اسکن میکنند، اما فقط به چند ستون خاص کار دارند؛ مثلاً «مجموع فروش در هر ساعت چقدر بوده؟». ClickHouse دقیقاً برای همین دنیا ساخته شده است.
اینطوری به آن نگاه کنید: یک دیتابیس معمولی دادهها را سطر به سطر ذخیره میکند، مثل دستهای از کارتهای فهرست. اما ClickHouse آنها را ستون به ستون نگه میدارد، مثل لیستهای جداگانه. اگر پرسش شما فقط به دو لیست نیاز داشته باشد، فقط همان دو لیست را میخواند و اصلاً کاری به بقیه ندارد. همین یک ایده، بخش بزرگی از سرعت فوقالعادهاش را توضیح میدهد.
مزایای دیگر هم بهطور طبیعی پشت سر همین ایده میآیند:
- فشردهسازی (Compression) بسیار عالی است، چون مقادیرِ داخل یک ستون شبیه به هم هستند. همان حجم داده، اغلب کسری از فضای قبلی را اشغال میکند.
- تفکیک دادهها بر اساس زمان (Time-based splitting) بهصورت پیشفرض در آن وجود دارد، بنابراین دادههای قدیمی را میتوان خیلی ارزان حذف یا آرشیو کرد. «نگه داشتن ۹۰ روز اخیر» تبدیل به یک تنظیم ساده میشود، نه یک پروژهی نگهداری سنگین.
- مقیاسپذیری افقی (Scaling out) جزئی از ذات طراحی آن است. هستههای بیشتر، ماشینهای بیشتر، با همان منطق قبلی.
اما بخشی که واقعاً شیوهی طراحی شما را عوض میکند اینجاست: وقتی اسکن کردن داده سریع و ارزان باشد، دیگر دست از پیشپخت کردن همهچیز برمیدارید. در دنیای قدیم، مجبور بودیم Jobهای شبانهی غولپیکری بسازیم تا همهی خلاصهها و جمعبندیها را از قبل محاسبه کنند، چون دیتابیس در لحظهی اجرای کوئری (Query time) طاقت این فشار را نداشت. با دیتابیسی مثل این، میتوانید دادههای خام و با جزئیات را نگه دارید و سوالاتتان را مستقیماً از آنها بپرسید. مراحل کمتر، Jobهای کمتر، و چیزهای کمتر برای خراب شدن.
چرا Airflow زندگی را راحتتر میکند؟
Airflow همان تکهی «چه کسی، چه کاری را و چه زمانی انجام دهد» است. بهترین راه برای درک کردنش این است: Airflow خودش کارهای سنگین را انجام نمیدهد. او رهبر ارکستر است، نه خودِ نوازندهها.
شما پایپلاین خود را بهصورت نقشهای از تسکهای کوچک و وابستگیهایشان تعریف میکنید. شاید در ظاهر کسلکننده به نظر برسد، اما چیزهایی به شما میدهد که ساختنشان به دست خودتان واقعاً دردناک است:
- خطا و شکست طبیعی است و مدیریت میشود. یک مرحله خطا میدهد؟ دوباره تلاش (Retry) میکند. باز هم خطا داد؟ به شما خبر میدهد. بقیهی پایپلاین از هم نمیپاشد.
- همهچیز را میبینید. هر اجرا، هر مرحله، چقدر طول کشیده و کجا خراب شده؛ همهچیز در یک صفحه. دیگر نیازی نیست برای فهمیدن اینکه دیشب چه اتفاقی افتاده، لابهلای لاگهای سرور بگردید.
- اجرای مجدد تاریخچه (Backfill) ساده است. متوجه مشکلی در سهشنبهی هفتهی پیش شدید؟ فقط همان بازهی زمانی را دوباره اجرا کنید. هیچ عملیات قهرمانانهای لازم نیست.
- طراحی موازی از پایه. به جای یک Job غولپیکر که همهچیز را پشت سر هم و خطی انجام میدهد، کار را به کلی تسک کوچک میشکنید که در کنار هم و موازی اجرا میشوند.
- همهچیز کد است. Review میشود، نسخهبندی میشود و تست میشود؛ درست مثل بقیهی نرمافزارهایتان.
و از آنجا که Airflow فقط نقش رهبر ارکستر را دارد، اصلاً برایش مهم نیست که کار واقعی روی چه ابزاری اجرا میشود. امروز ممکن است یک برنامهی کوچک باشد، فردا یک ابزار دیگر. شما هیچوقت در یک ابزار خاص حبس نمیشوید، و این آزادی ارزش بسیار بیشتری از هر قابلیت تکی دیگری دارد.
کارهای سنگین را به جایی بسپارید که به آن تعلق دارند
یک ایدهی طراحی دیگر: وقتی حجم داده بالاست، پردازش و خرد کردن واقعی دادهها نباید داخل یک ابزار گرافیکی انجام شود. جای آن در برنامههای کوچک و متمرکزی است که برای انجام یک کار و انجام سریع آن ساخته شدهاند و به زبانهایی نوشته شدهاند که مناسب این جنس کارها هستند. این برنامهها راحت تست میشوند، راحت روی هر ماشینی اجرا میشوند و با اجرای تعداد بیشتری از آنها، به سادگی مقیاسپذیر میشوند. Airflow به آنها میگوید چه زمانی اجرا شوند، و دیتابیس هم نتیجه را ذخیره میکند. به این ترتیب، هر بخش ساده باقی میماند.
هزینههای این مسیر (بخش صادقانهی ماجرا)
هیچکدام از اینها رایگان نیست، و اگر غیر از این بگویم دروغ گفتهام.
- به مجموعهی متفاوتی از مهارتها نیاز دارد. لینوکس، کدنویسی، Version Control. تیم شما برای یادگیری به زمان و حمایت نیاز دارد.
- دیتابیسهای تحلیلی (Analytical) برای هر کاری مناسب نیستند. آنها عاشق دادههایی هستند که میآیند و میمانند، اما با تعداد زیادی آپدیتهای کوچک میانهی خوبی ندارند. پس قبل از طراحی، باید با دقت به این فکر کنید که دادههایتان چطور تغییر میکنند.
- قطعات متحرک بیشتر. سه تکه به جای یک جعبه. هر تکه بهتنهایی سادهتر است، اما در نهایت باید بتوانید همهی آنها را خوب مدیریت و اجرا کنید.
- مهاجرت (Migration) کار واقعی و ریسک واقعی دارد. شما در حال تعویض موتور ماشین هستید، در حالی که ماشین دارد حرکت میکند.
و اگر بخواهیم در حق استک قدیمی انصاف را رعایت کنیم: اگر حجم دادههایتان متعادل است، تغییراتتان کند است و تیمتان در دنیای مایکروسافت به خوبی و خوشی زندگی میکند، همان SSIS و SQL Server ممکن است دقیقاً بهترین انتخاب برایتان باشند. صرفاً به خاطر مُد روز مهاجرت نکنید؛ وقتی مهاجرت کنید که دیگر شکل و قوارهی سیستم با اندازهی مسئلهتان جور درنمیآید.
اگر تصمیم به مهاجرت گرفتید
۱. با چالشیترین پایپلاین شروع کنید، نه سادهترین. این کار هم ارزشش را ثابت میکند و هم بیشترین چیز را به شما یاد میدهد.
۲. سیستم قدیمی و جدید را همزمان و در کنار هم اجرا کنید و اعداد را آنقدر مقایسه کنید تا این مقایسه برایتان کاملاً عادی و کسلکننده شود.
۳. تعاریف کسبوکار (Business definitions) را در قالبی خوانا و نسخهبندیشده نگه دارید تا مثل هر کد دیگری Review شوند.
۴. کاری کنید که تکرار هر اجرا بیخطر (Idempotent) باشد. یک Retry یا اجرای مجدد هرگز نباید دادهی تکراری بسازد.
۵. با پایپلاینها مثل یک محصول رفتار کنید؛ با مالک مشخص، تست و مستندات.
۶. منصفانه اندازهگیری کنید. قبل از مقایسه، سیستم قدیمی را هم درست تیون (Tune) کنید. یک بنچمارک صادقانه خیلی ارزشمندتر از یک مقایسهی نمایشی و اغراقآمیز است.
تغییر واقعی، در سوالی است که میپرسید
در دنیای قدیم، سوال معمولاً این است: «برای این کار از چه ابزاری استفاده کنم؟» اما در دنیای جدید، سوال تبدیل میشود به: «این سیستم باید چه شکلی داشته باشد تا بتواند بدون نیاز به بازنویسی کامل، به رشدش ادامه دهد؟»
این همان طرز فکری است که دوست دارم از این نوشته با خودتان ببرید. کارها را از هم جدا کنید. با پایپلاینها مثل کد رفتار کنید. فضای ذخیرهسازی را بر اساس سوالاتی که امروز واقعاً میپرسید انتخاب کنید، نه سوالاتی که ده سال پیش میپرسیدید.
ابزارها مدام تغییر میکنند، اما طراحی خوب خیلی بیشتر عمر میکند. در پست بعدی، قدمبهقدم یک پایپلاین مدرن را با دادههای ماک میسازیم تا خودتان هم بتوانید آن را اجرا کنید.